Cómo medir la visibilidad de tu marca en la búsqueda con IA
Construye un conjunto repetible de preguntas de compradores, inspecciona las fuentes citadas y prueba si un contenido más claro cambia la respuesta observada.
¿Te imaginas preguntarle a ChatGPT, Gemini o Perplexity cuál es el mejor software de tu categoría — y que el modelo nombre a tu marca como la opción definitiva, con un enlace de vuelta a ti?
En Random Truffle escuchamos esta pregunta casi todos los días de CEOs, CMOs y líderes de marketing: "¿Cómo posicionamos nuestra empresa dentro de los LLMs?" La respuesta corta es que no es una sola cosa. No puedes comprar un anuncio dentro de un prompt ni poner keywords en un meta tag y esperar que un modelo de razonamiento te cite. Posicionar una marca dentro de motores generativos exige un playbook nuevo: el paso del SEO a lo que los investigadores llaman Generative Engine Optimization (GEO), u Optimización para Búsqueda Agéntica (ASO).
Esta guía explica cómo los motores de búsqueda con IA evalúan la autoridad, por qué el SEO tradicional sigue siendo necesario pero ya no basta, y cómo un equipo de agentes autónomos puede ejecutar el trabajo de forma continua en lugar de una vez por trimestre.
Del SEO tradicional a la búsqueda agéntica
Durante dos décadas el SEO optimizó HTML estático para rastreadores: títulos, backlinks, volumen de keywords. El objetivo era una posición alta para que una persona hiciera clic en un enlace azul. Es el catálogo de una biblioteca: el bibliotecario te señala el pasillo 4, estante B, y te entrega cinco libros para que los leas tú.
La búsqueda agéntica funciona distinto. ChatGPT Search, Google AI Overviews, Perplexity, Gemini y Claude combinan modelos de lenguaje con pipelines de Generación Aumentada por Recuperación (RAG), navegación en vivo y ciclos de razonamiento multi-salto. En lugar de una lista, obtienes una única respuesta sintetizada con citas en línea que verifican cada afirmación.
¿Significa que el SEO murió? Para nada. La indexación clásica es el boleto de entrada al estadio; el GEO es cómo ganas el partido.
Cómo recuperan información los agentes de búsqueda
1. Descomposición del prompt
Cuando alguien pregunta "¿cuál es la mejor plataforma de automatización de marketing para retail de mercado medio?", el planificador no busca esa frase. Descompone el prompt en subconsultas atómicas: líderes de mercado, comparativas de funcionalidades, estándares de seguridad y cumplimiento, reseñas reales, precios y casos de éxito.
2. Ciclos RAG multi-salto
Después, el agente evalúa el contenido de cada página que abre. Si encuentra prosa promocional vaga, marca la evidencia como insuficiente, la descarta, reformula y busca en otro lado. Es un investigador hipereficiente con presupuesto de cómputo limitado: si tu página lo obliga a leer 1,000 palabras para encontrar un dato de precio, se va con el competidor cuyo primer párrafo entrega datos densos y estructurados.
Los cuatro pilares del posicionamiento en LLMs
Estas cuatro áreas ofrecen un marco práctico para probar la visibilidad. Registra el motor, el conjunto de consultas, la fecha y las fuentes citadas para poder comparar los cambios.
Pilar 1: Densidad de datos
Las estadísticas precisas — porcentajes, montos, fechas, benchmarks — son la palanca más efectiva. Los números eliminan la ambigüedad durante la síntesis. Cambia "aumentamos dramáticamente el ROI" por una afirmación verificable: qué cambió, cuánto, en cuánto tiempo y en cuántas implementaciones.
Pilar 2: Pirámide invertida y tablas
Los algoritmos de chunking parten la página en bloques pequeños, y los agentes favorecen desproporcionadamente el primer 30% del documento. Abre con una respuesta directa en las primeras 100 palabras. Convierte comparativas en tablas limpias: los modelos extraen y reproducen datos tabulares mucho más que texto corrido.
Pilar 3: Medios ganados y co-ocurrencia
Los modelos miden autoridad observando la co-ocurrencia de entidades en toda la web. Tu sitio es la prueba; el resto del ecosistema es el jurado.
Pilar 4: Gobernanza de entidades
Los LLMs contrastan su conocimiento interno con repositorios abiertos. Tu nombre legal, liderazgo, capacidades y taxonomía deben coincidir en Wikidata, Crunchbase, el Knowledge Graph de Google, Wikipedia y comunicados oficiales. Un footprint de entidad unificado es el seguro más barato contra alucinaciones.
Cómo los cuatro agentes ejecutan este ciclo
Auditar densidad de datos a mano, reescribir cientos de páginas, monitorear share of voice en cinco motores y coordinar medios ganados no es un proyecto trimestral: es un ciclo operativo continuo. Eso es exactamente lo que ejecutan los cuatro agentes de Random Truffle sobre tu Data Foundation.
Nexus — analítica y medición
Nexus es el marcador. Mide frecuencia de citas, share of voice y sentimiento por motor, audita la densidad de datos página por página y te dice qué temas están ganando y cuáles son invisibles. Pregúntale en español o en inglés; la respuesta se basa en tus propios datos.
Aura — estrategia de audiencias
Aura simula los prompts que escriben compradores reales en ChatGPT, Gemini, Perplexity y Claude, y mapea los huecos de cita: las preguntas donde tu categoría se responde y tu marca no aparece. Esa lista se convierte en el brief de contenido y medios.
Prism — estudio de contenido
Prism convierte esos briefs en activos extraíbles: respuestas directas en el primer párrafo, tablas comparativas, schema, FAQs y piezas visuales en marca. Contenido que se lee bien para personas y se parsea limpio para pipelines de recuperación.
Radian — operación de medios
Radian se encarga de la mitad off-page: dónde debe aparecer la marca, en qué publicaciones, plataformas de reseñas y comunidades, y con qué cadencia, para que las citas de terceros apunten de vuelta a ti.
Un solo ciclo, siempre activo: Nexus mide, Aura enfoca, Prism construye, Radian distribuye — y Nexus vuelve a medir.
Un plan operativo de GEO a 90 días
La mayoría de los equipos no falla en GEO porque las tácticas sean confusas, sino porque tratan el trabajo como un sprint de contenido y no como una cadencia operativa. Unos primeros 90 días realistas se ven así.
Días 1-30: línea base e higiene de entidades
Arma un set de 50 a 150 preguntas reales de compradores de tu categoría y registra, motor por motor, si te citan, te mencionan sin enlace o estás ausente. Ese es tu AI Share of Voice inicial. En paralelo, reconcilia tu footprint de entidad — nombre legal, año de fundación, categoría, liderazgo, taxonomía de producto — en Wikidata, Crunchbase, LinkedIn y tus propias páginas, para que ninguna fuente se contradiga.
Días 31-60: reescribe las páginas que ya posicionan
Empieza por las páginas que ya aparecen en la primera página de resultados. Reescribe cada una para que la respuesta directa quede en las primeras 100 palabras, las comparativas se vuelvan tablas y cada superlativo vago se reemplace por una cifra, una fecha y una fuente.
Días 61-90: medios ganados y nueva medición
El último tramo es off-page: notas de analistas, plataformas de reseñas, medios de industria y comunidades de práctica donde tu marca deba co-ocurrir con los términos de tu categoría. Después vuelve a correr el mismo set de prompts en los mismos motores. El resultado es el delta, no la anécdota.
Qué páginas priorizar primero
No todas las páginas ganan citas. Los motores generativos extraen de forma desproporcionada de cuatro tipos: comparativas que nombran alternativas reales, páginas de precios y costos con cifras explícitas, páginas de metodología que explican cómo se mide algo, y casos de éxito con resultados y plazos concretos. Los ensayos de liderazgo de opinión sin datos extraíbles casi nunca se citan, por bien escritos que estén.
Una prueba práctica antes de publicar: ¿podría un modelo tomar un solo párrafo de esta página, citarlo como respuesta autónoma y seguir siendo exacto? Si no, la página todavía no es recuperable: es solo prosa.
Preguntas frecuentes
¿Cuál es la diferencia entre SEO y GEO?
El SEO gana posiciones en la página de resultados para generar clics. El GEO estructura el contenido con alta densidad de datos, respuestas directas y entidades claras para que los modelos sinteticen y citen tu marca dentro de la respuesta generada.
¿Para qué motores debemos optimizar?
Prioriza los motores con recuperación en tiempo real: ChatGPT Search (apoyado en el índice de Bing), Google AI Overviews y AI Mode, Perplexity, Gemini y Claude.
¿Cuánto tardan los resultados?
El tiempo necesario para observar un cambio varía según el motor, la página y la consulta. Repite el mismo conjunto de consultas durante un periodo definido y reporta tanto la variación como el promedio.
¿Cómo se mide la visibilidad en LLMs?
Con tres métricas: Frecuencia de Citas de IA (cuántas veces se enlaza tu dominio), Share of Voice en IA (qué porcentaje de prompts de categoría te recomienda) y Sentiment Grounding (qué tan preciso es lo que el modelo dice de ti).
Reclama tu lugar dentro de la respuesta
La era de recorrer diez enlaces azules está terminando. Los compradores quieren una respuesta sintetizada y confiable — y los modelos de lenguaje se están convirtiendo en los guardianes de esa respuesta. Posicionarse dentro de ellos no es un truco: es una disciplina operativa de densidad de datos, claridad estructural, autoridad ganada e higiene de entidades.
Random Truffle ejecuta esa disciplina de forma continua, sobre tus propios datos y todo el contexto de tu marca. Agenda una demo y descubre cómo Nexus, Aura, Prism y Radian convierten a tu marca en la respuesta por defecto de tu categoría.
Cuatro agentes. Un entendimiento compartido.
Explora cómo Nexus, Aura, Prism y Radian convierten una pregunta en evidencia, creatividad y acción.
Conoce a los agentes →Sigue explorando.
 IA y marketing / 5 MIN DE LECTURA
Un playbook que los agentes puedan usar
Conserva las reglas de marca y las instrucciones de trabajo en skills reutilizables, con versiones, responsables y pasos de revisión claros.
Lee la nota de campo →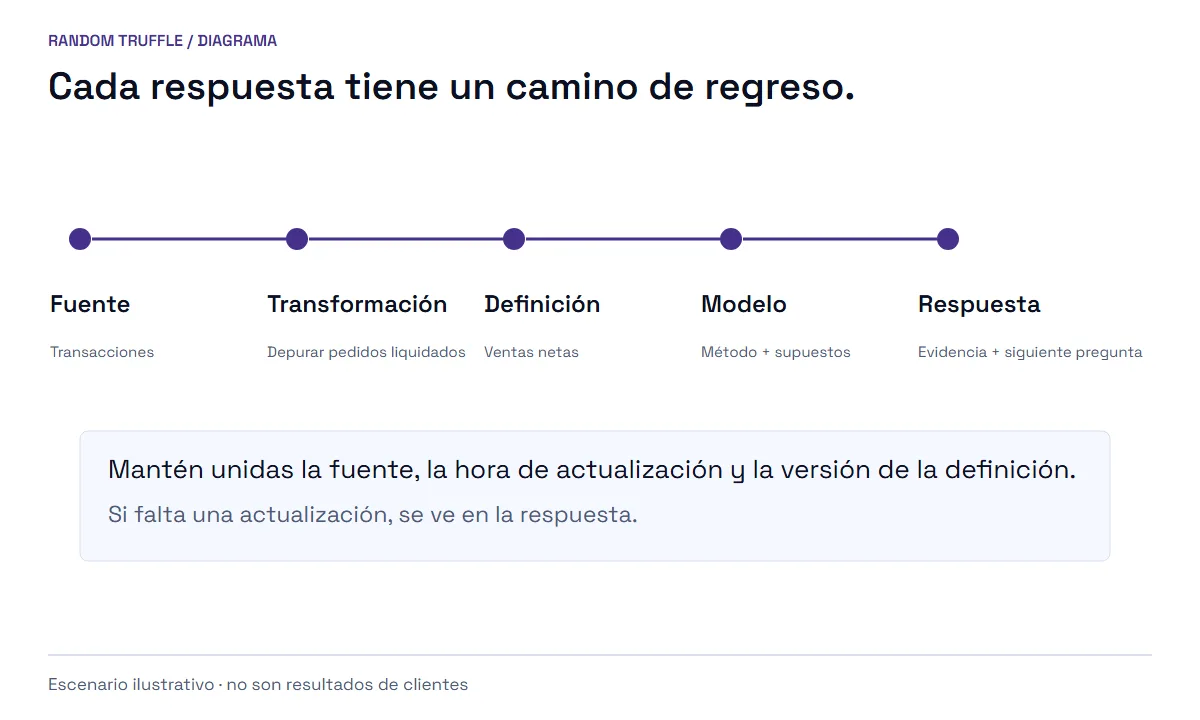 IA y marketing / 10 MIN DE LECTURA
La IA útil empieza con definiciones de negocio
Define el cliente, la conversión y el resultado de negocio antes de pedirle a un agente que actúe sobre los datos.
Lee la nota de campo →